- Versand ab Lager Schweiz
- Nachhaltig: Refurbished statt neu
- 1 Jahr Garantie
- Kauf auf Rechnung
← Zurück zur Übersicht

Qwen3.6-35B-A3B
Alibaba (Qwen)
Apache 2.0
Offenes Sprachmodell für Chat und Text. 2 Grössen von 27.8B bis 36B Parametern, teils Mixture-of-Experts (nur ein Teil der Parameter ist pro Token aktiv).
- Mixture-of-Experts: 36.0B Parameter insgesamt, davon 3.0B pro Token aktiv. Der Speicherbedarf richtet sich nach allen Parametern, das Tempo nach den aktiven.
Einstellungen
Qualität
4 Bit (Q4_K_M) ist die gängigste Wahl: gute Qualität bei geringem Speicherbedarf.
Kontextlänge: 8k Tokens
4k256k
Wie viel Text das Modell gleichzeitig im Blick hat. Mehr Kontext braucht mehr Speicher.
Empfehlung
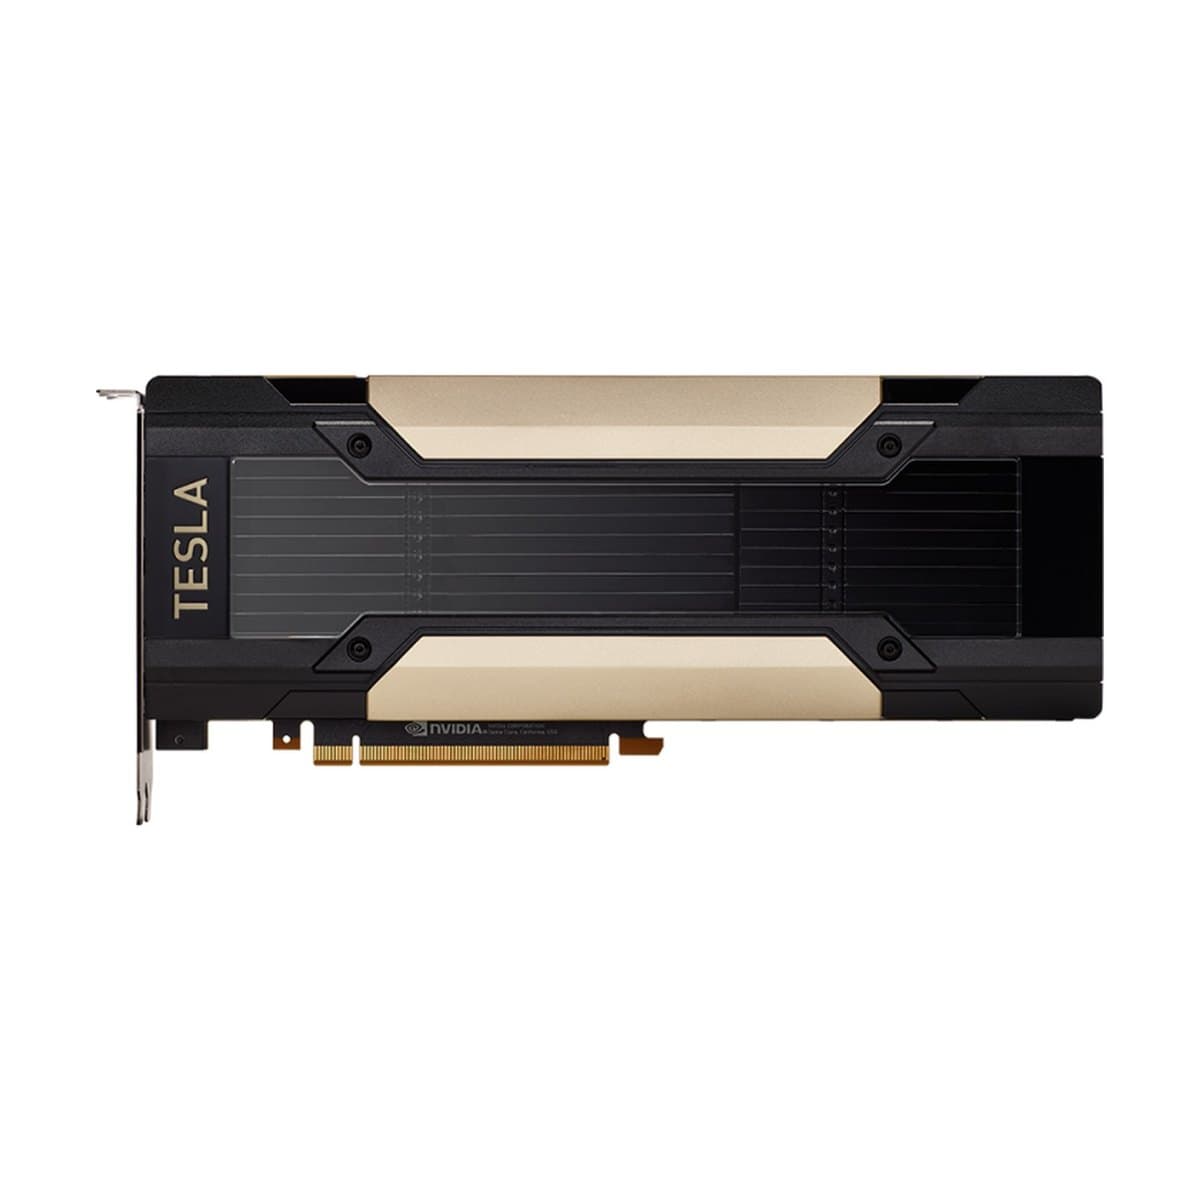
1× Tesla V100 32 GB
Das Modell braucht rund 23.3 GB Speicher. Passiv gekühlt, Lüfter und 8-Pin-EPS-Kabel nötig.
- Gewichte
- 21.6 GB
- KV-Cache
- 0.2 GB
- Geschwindigkeit
- ~261.7 Tok./s
Weitere passende Konfigurationen
| Karte | Anzahl | Tok./s | Status |
|---|---|---|---|
| Tesla T4 16 GB | 2× | 87.0 | 2-3 Wochen Lieferfrist |
| Tesla P100 16 GB | 2× | 109.6 | 2-3 Wochen Lieferfrist |
| Tesla P40 24 GB | 2× | 102.7 | 2-3 Wochen Lieferfrist |
| Tesla V100 16 GB | 2× | 242.3 | 2-3 Wochen Lieferfrist |
| Tesla V100 32 GB | 1× | 261.7 | an Lager |
| AMD Instinct MI50 16 GB | 2× | 185.8 | 2-3 Wochen Lieferfrist |
| AMD Instinct MI50 32 GB | 1× | 200.6 | 2-3 Wochen Lieferfrist |
| AMD Instinct MI60 32 GB | 1× | 185.3 | 2-3 Wochen Lieferfrist |
| AMD Instinct MI100 32 GB | 1× | 224.0 | 2-3 Wochen Lieferfrist |
| A30 24 GB | 2× | 234.4 | 2-3 Wochen Lieferfrist |
| RTX A5000 24 GB | 2× | 244.3 | 2-3 Wochen Lieferfrist |
| A40 48 GB | 1× | 251.6 | 2-3 Wochen Lieferfrist |